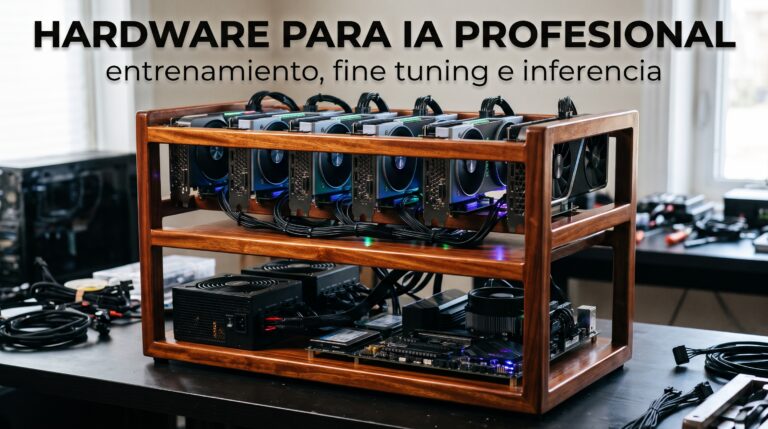
Para comprar hardware para IA local con LM Studio, identifica primero qué te impide usar el modelo elegido: memoria de la gráfica, RAM del ordenador, espacio para archivos o falta de un equipo compatible. Una GPU de 16 GB, un kit de 64 GB y un SSD de 2 TB resuelven problemas distintos. Si empiezas desde cero, un Mac mini M4 con 24 GB de memoria unificada ofrece otra vía que también exige dimensionar el contexto y el uso simultáneo.
Esta comparativa reúne cuatro compras concretas y sus condiciones de compatibilidad. Consulta los requisitos del modelo y del software antes de elegir una ampliación. Las fichas permiten consultar estos modelos en Amazon España. Confirma la referencia y la configuración exactas, identifica al vendedor y revisa el contenido, el precio final y la disponibilidad antes de pagar.
Qué comprar según el límite que tienes
Desliza la tabla para ver todas las columnas
| Producto exacto | Cuándo valorarlo | Comprobación decisiva |
|---|---|---|
| ASUS Dual RTX 5060 Ti OC 16 GB, DUAL-RTX5060TI-O16G | Ampliar un sobremesa para cargar más trabajo en GPU | Caja, fuente, controlador y motor CUDA compatible |
| Kingston FURY Beast KF556C40BBK2-64 | Ampliar RAM de un sobremesa DDR5 compatible | Kit DIMM de 2 × 32 GB y soporte de placa y procesador |
| Samsung 990 EVO Plus 2 TB, MZ-V9S2T0BW | Conservar modelos y cuantizaciones sin quedarse sin disco | Ranura M.2 2280 con NVMe y espacio disponible |
| Mac mini M4 de 2024, CPU/GPU de 10 núcleos, 24 GB y SSD de 512 GB | Comprar un ordenador completo con Apple Silicon | Memoria y SSD de la variante seleccionada; motor y formato del modelo |
No hace falta comprar los cuatro. La ampliación lógica conserva lo que ya funciona y corrige un límite observado. Si aún estás decidiendo dónde procesar tus datos, empieza por las diferencias entre IA local y nube; aquí el objetivo es elegir recursos para ejecutar modelos en el equipo.
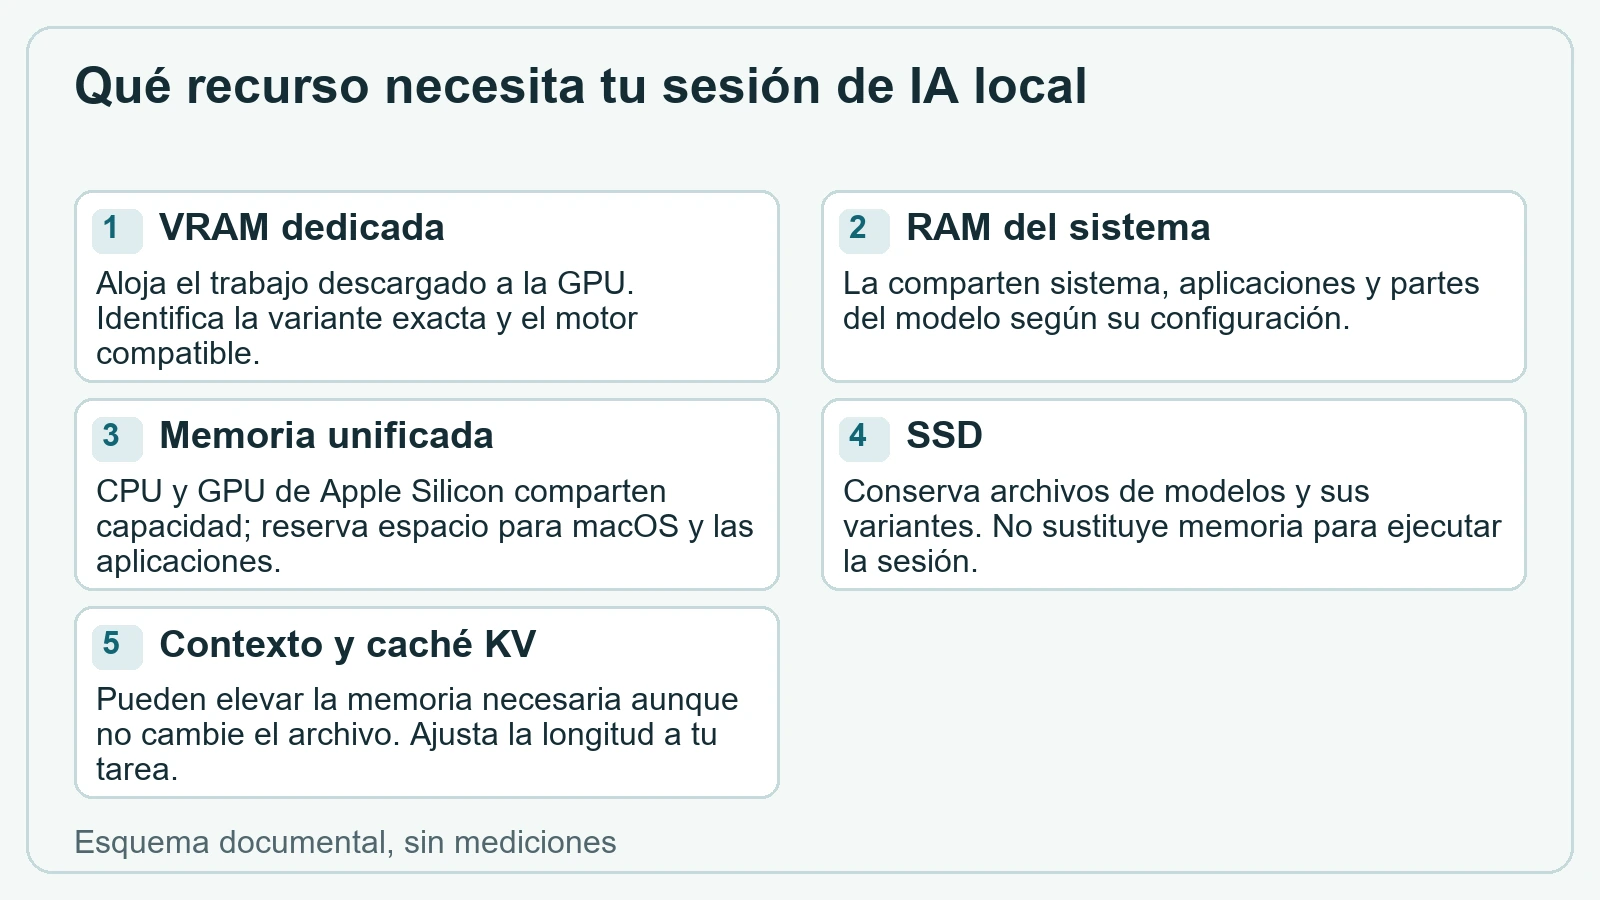
- VRAM dedicada: Aloja el trabajo descargado a la GPU. Identifica la variante exacta y el motor compatible.
- RAM del sistema: La comparten sistema, aplicaciones y partes del modelo según su configuración.
- Memoria unificada: CPU y GPU de Apple Silicon comparten capacidad; reserva espacio para macOS y las aplicaciones.
- SSD: Conserva archivos de modelos y sus variantes. No sustituye memoria para ejecutar la sesión.
- Contexto y caché KV: Pueden elevar la memoria necesaria aunque no cambie el archivo. Ajusta la longitud a tu tarea.
RAM, VRAM y memoria unificada: qué estás comprando
La RAM aloja el sistema operativo, aplicaciones y recursos de la ejecución. La VRAM es la memoria propia de una GPU dedicada. En Apple Silicon, CPU y GPU comparten memoria unificada. Esas arquitecturas distribuyen el trabajo de manera diferente: sumar 64 GB de RAM a una gráfica de 8 GB no produce una gráfica de 72 GB.
LM Studio permite utilizar motores y configuraciones diferentes. La cantidad de trabajo descargada a GPU depende del motor, el modelo y los ajustes. Cuando parte queda en CPU y RAM, no debes asumir la misma respuesta que con otra distribución. La capacidad ayuda a decidir qué cabe; para saber si la espera te resulta aceptable necesitas probar tu tarea.
La documentación de requisitos de LM Studio recomienda al menos 16 GB de RAM y 4 GB de VRAM dedicada en Windows; en x64 pide AVX2. Para Mac exige Apple Silicon y macOS 14 o posterior, con 16 GB de RAM recomendados. Son requisitos generales de la aplicación, no una promesa de que cualquier modelo o contexto funcionará con esas cantidades.
Cuantización y contexto: calcula algo más que el archivo
El mismo modelo puede ocupar cantidades diferentes
Cuantizar reduce la precisión con la que se representan determinados valores. El ahorro puede cambiar las respuestas y debe evaluarse con ejemplos propios. No elijas únicamente la descarga más pequeña: comprueba idioma, seguimiento de instrucciones y fidelidad al resumir tus documentos.
Como referencia identificable, el repositorio oficial Qwen/Qwen3-8B-GGUF publica una variante Q4_K_M de 5,03 GB y otra Q8_0 de 8,71 GB. Son tamaños de archivos, no consumos totales de memoria ni resultados de velocidad. La etiqueta de cuatro bits tampoco significa que cada byte del archivo corresponda a pesos uniformemente almacenados con esa precisión.
Ejemplo orientativo de caché KV
El contexto incluye instrucciones, conversación, documentos introducidos y espacio para la respuesta. Alargarlo puede aumentar la memoria de la caché de atención, denominada KV. Reservar el máximo contexto por costumbre puede cerrar la puerta a una configuración que sí sería útil con menos texto.
Este cálculo es puramente orientativo, no una medición de LM Studio: tomamos de la configuración de Qwen3-8B 36 capas, 8 cabezas KV y dimensión 128. Suponemos una sola secuencia, claves y valores en FP16, dos bytes por elemento y caché completa sin cuantizar. La cuenta es 2 × capas × cabezas KV × dimensión × tokens × bytes.
Con esos supuestos, 8.192 tokens dan 1.207.959.552 bytes, equivalentes a 1,125 GiB de caché; 32.768 tokens dan 4,5 GiB. Solo representa esa caché idealizada. Faltan pesos, buffers, recursos gráficos, reservas del motor y aplicaciones. La ubicación y asignación real, el tipo de caché, el procesamiento por lotes y varias peticiones pueden cambiar el resultado. GB decimal y GiB tampoco son la misma unidad.
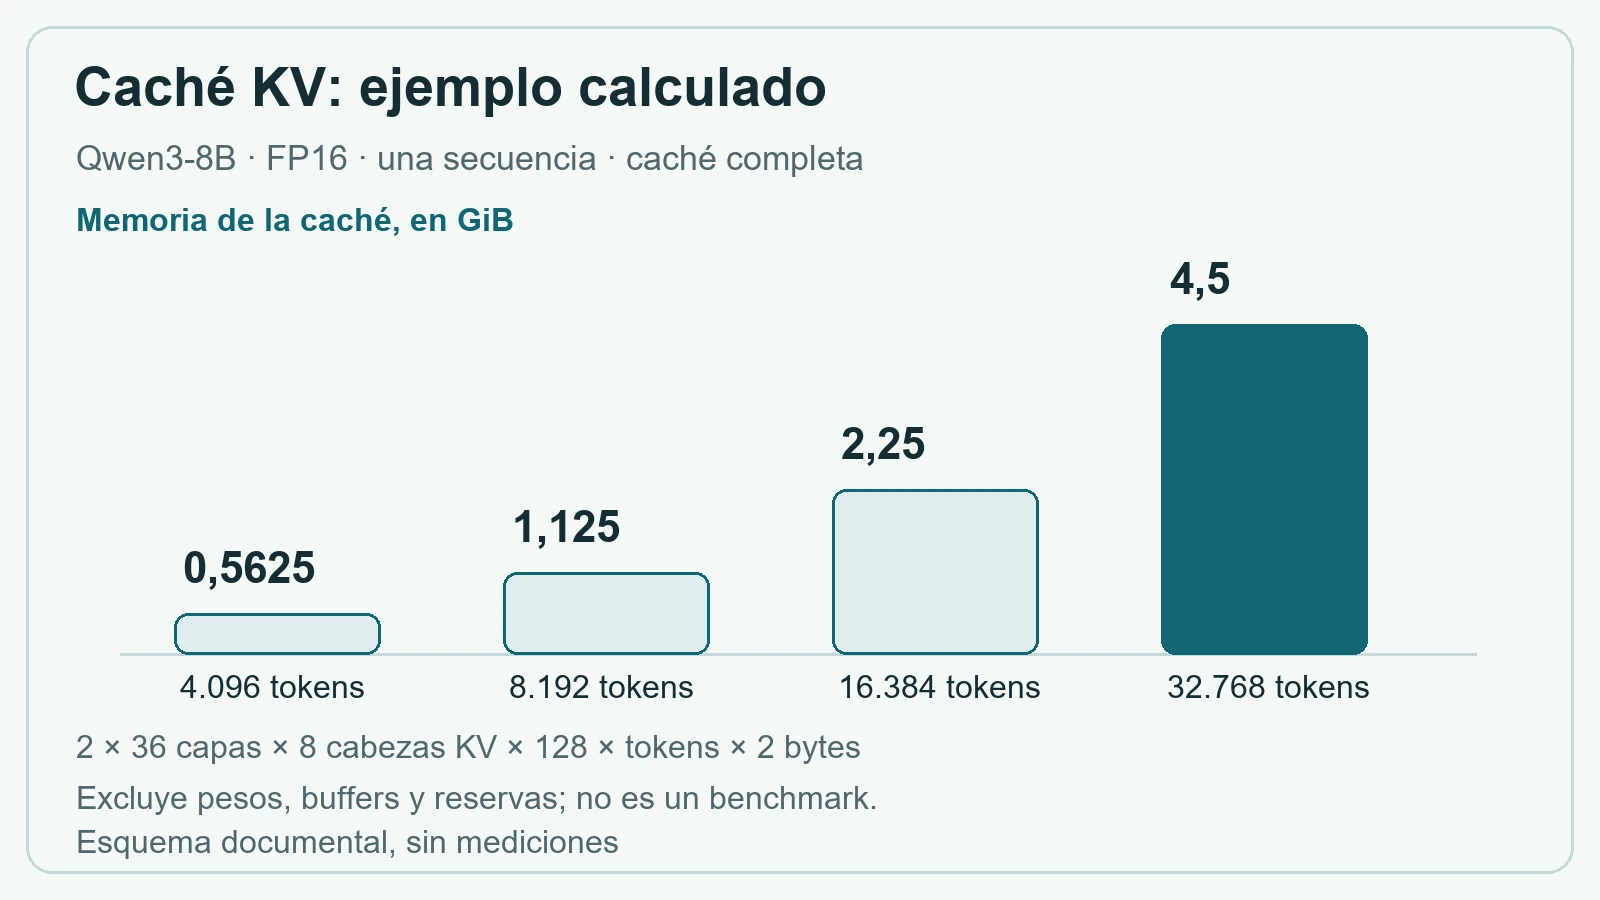
La utilidad de la cuenta es mostrar por qué dos sesiones con el mismo archivo pueden necesitar distinta memoria. No sirve para garantizar que un modelo cabe entero en una tarjeta ni para extrapolar a cualquier arquitectura. Revisa la estimación que muestre tu versión y después observa la ejecución real.
1. ASUS Dual RTX 5060 Ti OC de 16 GB: ampliar la GPU
La referencia DUAL-RTX5060TI-O16G aporta 16 GB de GDDR7 dedicada. ASUS documenta 229 × 120 × 50 mm, ocupación de 2,5 ranuras, un conector de ocho pines y una fuente recomendada de 550 W. Esa recomendación exige valorar el conjunto del PC.
Comprueba el espacio con cables y tarjetas vecinas, la alimentación y la refrigeración antes de buscar una oferta. NVIDIA distingue versiones de 16 y 8 GB dentro de la familia RTX 5060 Ti: el nombre del chip por sí solo no identifica esta compra.
LM Studio documentó soporte de RTX 50 con CUDA 12.8 en sus motores llama.cpp para Windows y Linux. Instala una versión actual y revisa el motor y un controlador que admita esta tarjeta. Una nota histórica de soporte no sustituye comprobar la combinación instalada.
La elegiría después de confirmar que mi tarea necesita más memoria dedicada y que el sobremesa admite la ampliación. No deduciría tokens por segundo de los TOPS anunciados ni del rendimiento en juegos. Tampoco compraría esta tarjeta suponiendo que 16 GB bastan para todo contexto o modelo.
2. Kingston FURY Beast 64 GB: ampliar la memoria del PC
El KF556C40BBK2-64 es un kit de dos DIMM DDR5 de 32 GB para sobremesa. Su ficha técnica documenta perfil XMP 3.0 a 5.600 MT/s y configuración JEDEC de 4.800 MT/s. La velocidad del perfil requiere soporte y ajuste adecuados; no debe darse por automática.
Antes de elegirlo, consulta la capacidad total y por ranura admitida por placa y procesador, la lista de memorias validadas cuando exista y la versión de BIOS necesaria. Este formato no encaja en ranuras SO-DIMM de muchos mini PC o portátiles ni en placas DDR4. Tampoco amplía la memoria unificada de un Mac mini.
Es una opción si has observado presión de RAM con tus modelos, aplicaciones o cargas repartidas entre CPU y GPU. Ampliar capacidad puede evitar un límite de memoria; no garantiza que una tarea lenta se vuelva rápida. Si ya tienes RAM libre y la gráfica está llena, vuelve a investigar la distribución del trabajo antes de comprar.
3. Samsung 990 EVO Plus 2 TB: guardar modelos
El Samsung MZ-V9S2T0BW es un SSD NVMe M.2 2280. Samsung documenta interfaces PCIe 4.0 ×4 y 5.0 ×2. Comprueba el manual del ordenador: compartir forma M.2 no demuestra soporte NVMe ni disponibilidad de líneas o espacio.
Esta compra tiene sentido cuando mantienes varios modelos, revisiones y cuantizaciones y el disco actual se queda pequeño. Haz antes inventario de archivos duplicados y versiones que realmente utilizas. Deja espacio para sistema y descargas pendientes; dos terabytes nominales no equivalen a dos terabytes libres para modelos.
El SSD conserva archivos y participa en su carga. No añade VRAM ni sustituye la RAM necesaria para ejecutar un modelo. Las cifras máximas secuenciales del fabricante tampoco indican cuántas palabras generará el asistente. Para conectarlo externamente necesitas una caja NVMe compatible, comprada y comprobada por separado. No lo trates como una ampliación interna intercambiable del Mac mini.
4. Mac mini M4 24 GB/512 GB: elegir un equipo completo
La variante analizada es el Mac mini de 2024 con M4, CPU y GPU de 10 núcleos, 24 GB de memoria unificada y SSD de 512 GB. Apple documenta esa configuración; no debes confundirla con M4 Pro, con 16 GB o con otro tamaño de SSD.
LM Studio admite llama.cpp para GGUF y MLX en Apple Silicon. Selecciona el archivo correspondiente al motor: un repositorio MLX y un GGUF no son formatos intercambiables. Reserva memoria para macOS y las demás aplicaciones; los 24 GB anunciados no son 24 GB íntegros de memoria libre para el modelo.
Lo consideraría cuando hace falta un ordenador completo y encajan macOS y sus programas. Evalúa la memoria al comprar y no presupongas ampliaciones posteriores mediante módulos DIMM. Tampoco atribuyas a LM Studio una aceleración automática por el Neural Engine. El vídeo oficial siguiente presenta el equipo; no es una prueba de modelos locales.
Autor: Apple UK. Contenido externo; no es una prueba de Valinkey. Al reproducir se establecerá conexión con YouTube.
Prueba primero con el equipo que ya tienes
- Define tres tareas repetibles: una pregunta breve, un resumen y una consulta con un documento representativo sin datos sensibles.
- Instala LM Studio desde su web y comprueba los requisitos de tu sistema. Sigue su guía para descargar y cargar un modelo.
- Anota repositorio, archivo, cuantización, motor, versión, contexto y distribución CPU/GPU. Conserva las mismas entradas para comparar cambios.
- Empieza con contexto moderado y una sola conversación. Observa memoria disponible, posibles errores, intercambio a disco y calidad de las respuestas.
- Prueba el contexto que de verdad necesitas. Cambia un ajuste cada vez; si registras tiempos, distingue carga, primera respuesta y generación con idénticas condiciones.
Si la calidad es suficiente y la espera encaja con tu trabajo, puedes aplazar la compra. Si falla la carga por memoria, revisa cuantización y contexto. Si falta disco, considera almacenamiento. Cuando todo cabe pero la respuesta tarda demasiado, reúne observaciones antes de decidir entre GPU, otro ordenador o una tarea más acotada.
Para una máquina que además gestione la vivienda, separa disponibilidad y mantenimiento con la guía de equipos para domótica. Aplica también el método de comprobación de compatibilidad al inventario: referencia exacta, requisitos documentados y dudas pendientes.
Preguntas frecuentes antes de comprar
¿64 GB de RAM equivalen a 16 GB de VRAM?
No hay una equivalencia directa. Son ubicaciones de memoria con funciones y acceso diferentes. Comprueba cómo reparte el motor tu modelo y evalúa el resultado con la tarea prevista.
¿Una cuantización más pequeña siempre conviene?
Permite reducir el tamaño, pero debes comprobar qué ocurre con las respuestas. Conserva ejemplos cuya solución conozcas, especialmente cifras, instrucciones y detalles que el resumen no puede omitir.
¿Puedo usar el contexto máximo publicado por el modelo?
El límite del modelo no demuestra que tu hardware pueda reservarlo con la configuración elegida. Cuenta también el texto de salida, ajusta el contexto y observa memoria y comportamiento.
¿Cómo elijo entre las cuatro compras?
Relaciona cada compra con una evidencia: VRAM insuficiente, RAM saturada, disco lleno o necesidad de equipo completo. Si no puedes señalar ese límite, completa primero la prueba y compara el coste total de la solución compatible.
Dónde comprar los productos de esta guía
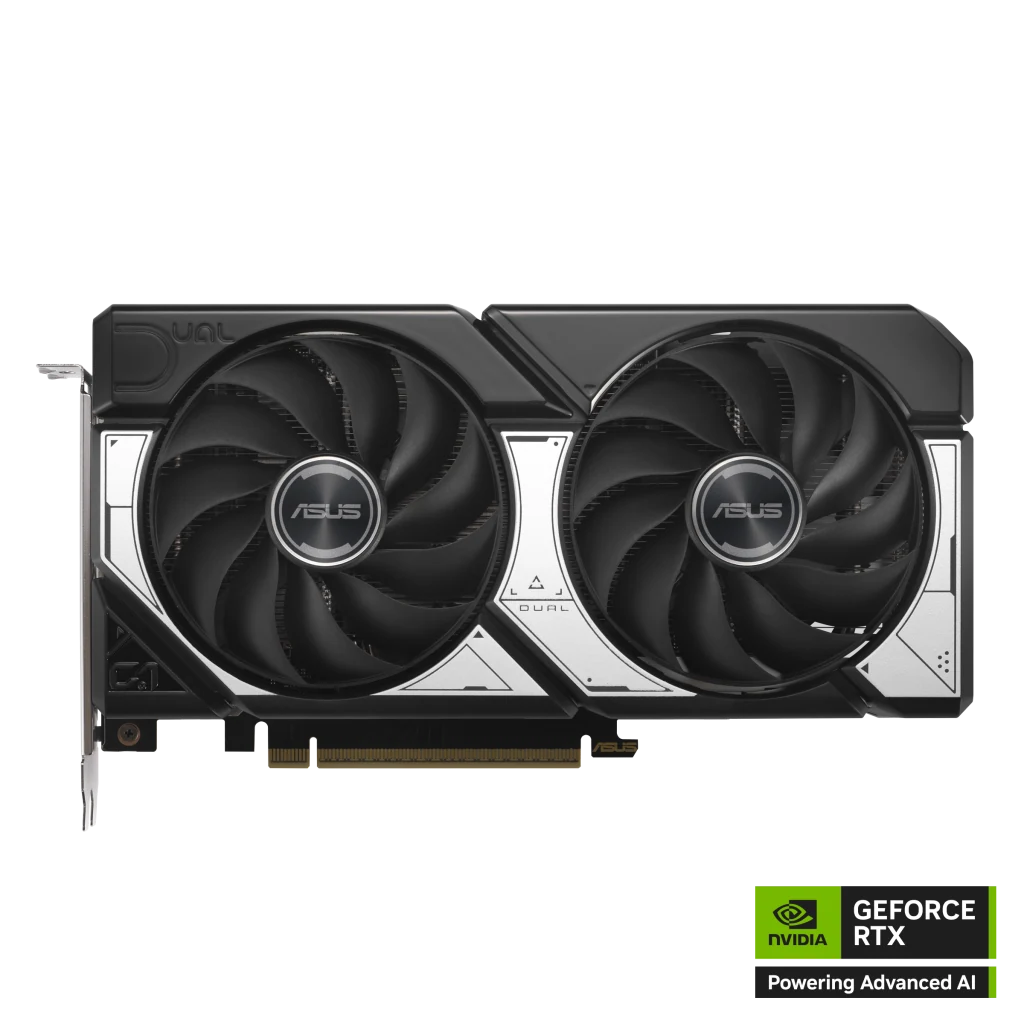
ASUS Dual RTX 5060 Ti OC 16 GB
GPU dedicada para ampliar un sobremesa compatible; dimensiona pesos y contexto antes de elegir.
Ver en Amazon Enlace de afiliado
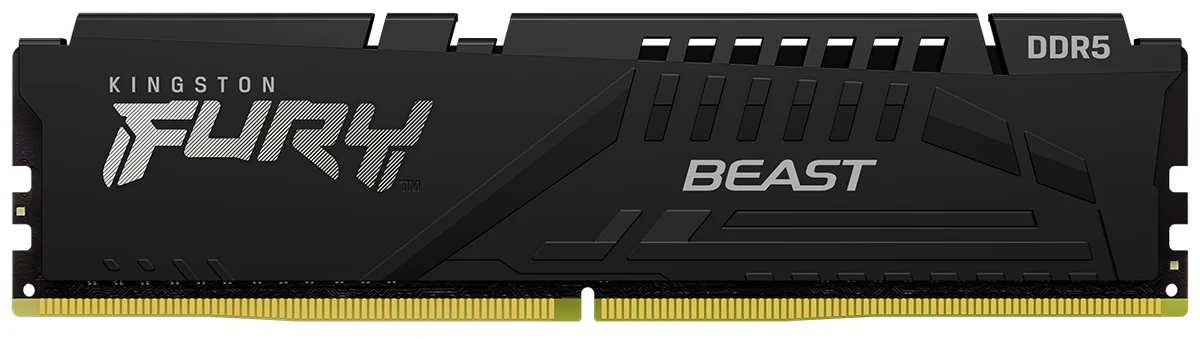
Kingston FURY Beast 64 GB
Kit DIMM para ampliar RAM de sobremesa cuando el límite observado es la memoria del sistema.
Ver en Amazon Enlace de afiliado
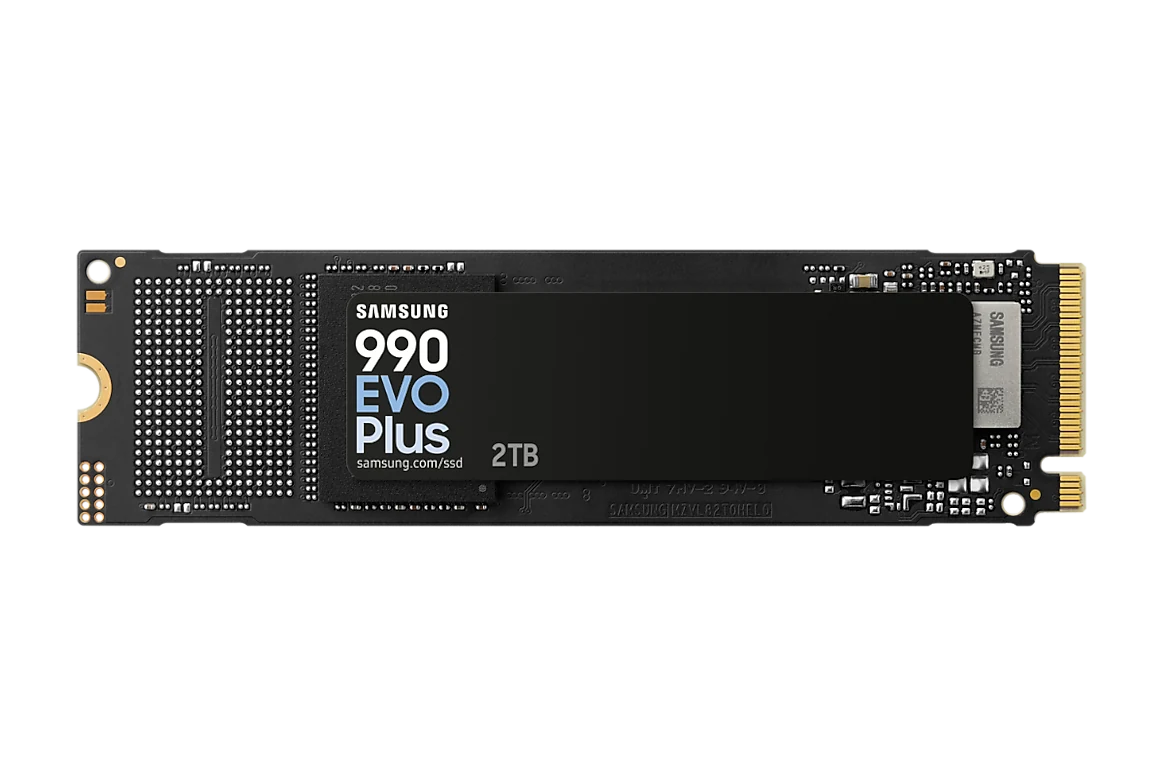
Samsung 990 EVO Plus 2 TB
Almacenamiento para modelos y variantes; no sustituye RAM ni memoria dedicada de GPU.
Ver en Amazon Enlace de afiliado
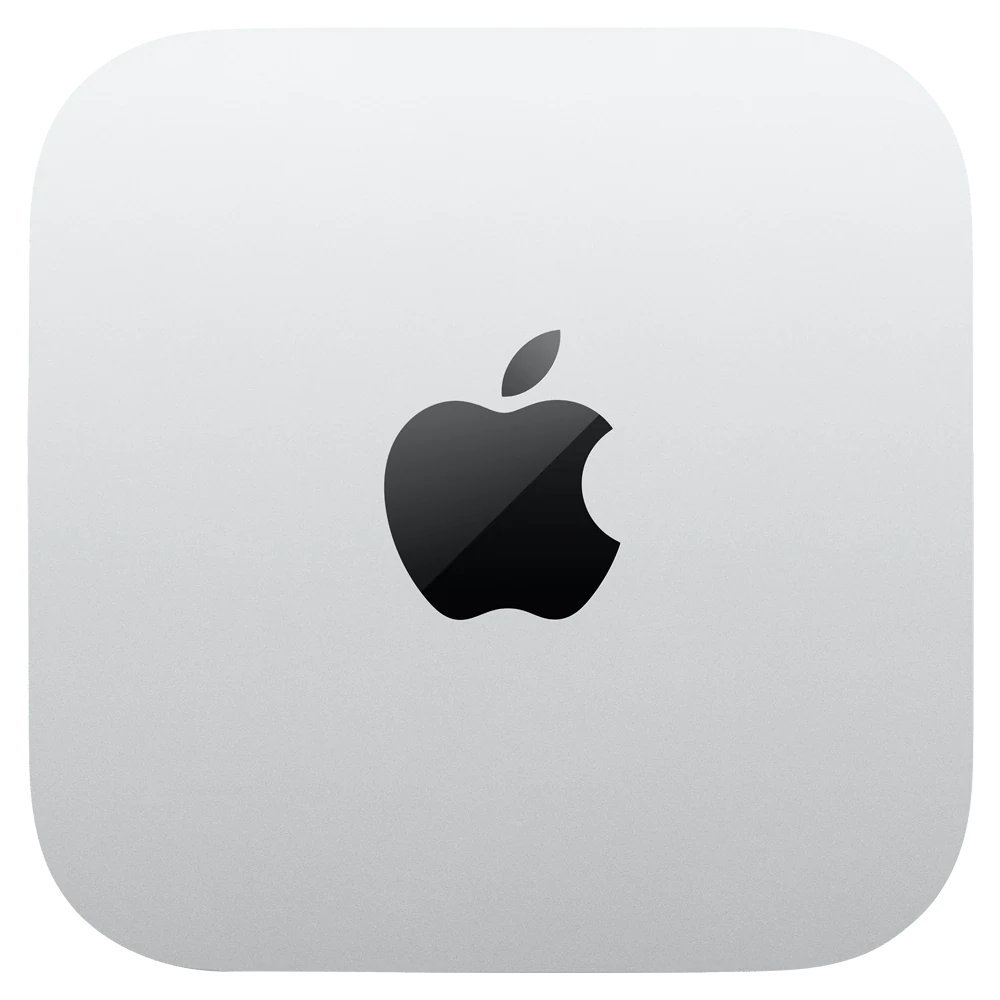
Mac mini M4 · 24 GB / 512 GB
Ordenador completo con Apple Silicon; revisar memoria compartida, motor y configuración de compra.
Buscar en Amazon Enlace de afiliado
Comprueba la referencia, el vendedor y las condiciones actuales en Amazon.
Fuentes consultadas
- LM Studio: requisitos del sistema
- LM Studio: motores llama.cpp y MLX
- LM Studio 0.3.15: soporte de NVIDIA RTX 50 con CUDA 12.8
- ASUS: DUAL-RTX5060TI-O16G, especificaciones técnicas
- NVIDIA: especificaciones de la familia GeForce RTX 5060
- Kingston: ficha técnica KF556C40BBK2-64
- Samsung: 990 EVO Plus 2 TB MZ-V9S2T0BW
- Apple: Mac mini (2024), especificaciones técnicas
- Qwen: repositorio oficial Qwen3-8B-GGUF y tamaños de cuantizaciones
- Qwen: configuración oficial de Qwen3-8B para el cálculo orientativo de KV
- LM Studio: primeros pasos
Revisión de fuentes: 25 de octubre de 2026.